خلاصه در یک نگاه
- آمادگی برای هوش مصنوعی ویژگی یک کار است، نه کل سازمان؛ همان سازمان ممکن است برای یک کار آماده باشد و برای کار دیگر نه.
- بیست پرسش در پنج محور (کار و نتیجه، منبع و داده، معنا و تعریف، اختیار و تأیید، ارزیابی و ریسک) با نمرهٔ ۰ تا ۲ کافی است تا به تصمیم برسید.
- سه پرسش خط قرمزند؛ حساسیت داده، مسئول تأیید انسانی و شرط توقف. اگر هر کدام صفر باشد، پاسخ «فعلاً نه» است.
- نمره به یکی از سه تصمیم میرسد؛ شروع آزمایشی محدود، آمادهسازی هدفمند یا فعلاً نه، و هر کدام گام بعد مشخص دارد.
- این خودارزیابی جای ممیزی امنیت، بررسی حقوقی یا انتخاب فروشنده را نمیگیرد.
فهرست مطالب
هیئتمدیره پرسیده «برنامهٔ هوش مصنوعیمان چیست؟»، دو فروشنده پیشنهاد «ارزیابی آمادگی» دادهاند و چند نفر از تیم بیسروصدا با دستیارهای هوش مصنوعی عمومی گزارش مینویسند. میخواهید شروع کنید، اما نه با پروژهای بزرگ که چند ماه بعد بینتیجه بماند.
پاسخ کوتاه این است: آمادگی سازمان برای هوش مصنوعی را در دامنهٔ یک کار مشخص بسنجید، نه برای کل سازمان. این مقاله بیست پرسش در پنج محور میدهد (کار و نتیجه، منبع و داده، معنا و تعریف، اختیار و تأیید، ارزیابی و ریسک) و قاعدهای که نمره را به یکی از سه تصمیم تبدیل میکند؛ شروع آزمایشی محدود، آمادهسازی هدفمند یا فعلاً نه.
چهار محور آخر همان چهار ستون صفحهٔ سازمان آماده AI است؛ منبع، معنا، اختیار و ارزیابی. محور اول، یعنی روشنبودن خروجی کار، از مقالهٔ پیش از ورود عاملها، شناخت سازمان را روشن کنیم میآید. اجرای خودارزیابی با سه نفر حدود ۴۵ دقیقه وقت میگیرد (برآورد ما) و به هیچ ابزار یا فروشندهای نیاز ندارد؛ چه کار را به یک دستیار ساده بسپارید، چه به یک عامل هوش مصنوعی (AI Agent).
چرا نمرهٔ کلی آمادگی به تصمیم نمیرسد؟
نمرهٔ کلی آمادگی، مثل «سطح ۲ از ۵»، میانگین کارهایی است که آمادگیشان با هم فرق دارد؛ برای همین نمیگوید فردا کدام کار را شروع کنیم و کدام را نه. سه دلیل این را روشنتر میکند.
آمادگی از کاری به کار دیگر فرق میکند. یک شرکت پخش فرضی را در نظر بگیرید. تهیهٔ پیشنویس گزارش هفتگی آمادگی مرکز توزیع، منابع مشخص، مسئول تأیید و خروجی قابل بازبینی دارد. بهروزرسانی خودکار وضعیت سفارشها در سامانهٔ فروش، در همان شرکت، نه تعریف مشترکی از «تحویلشده» دارد و نه کسی که پیش از اطلاع به مشتری خروجی را ببیند. یک سازمان، دو کار، دو جواب؛ هر دو را در بخش نمونهها پرسشبهپرسش نمره دادهایم.
نمرهٔ کلی گام بعد ندارد. «سطح ۲» نمیگوید کدام سند را باید مرتب کرد یا کدام نقش باید تأیید کند. پرسشی که به یک کار بسته است، کمبود را هم مشخص نشان میدهد. «تعریف مکتوب "آماده" را نداریم» کاری است که در یک هفته انجام میشود.
ارزیابی فروشنده از دریچهٔ محصول خودش نگاه میکند. این بدنیتی نیست؛ طبیعی است که هر فروشنده پرسشهایی بپرسد که پاسخشان به راهحل خودش میرسد. همین دربارهٔ کرسی (Korsi) هم صادق است، و به همین دلیل این خودارزیابی را طوری نوشتهایم که بدون هیچ محصولی اجرا شود.
چارچوب مدیریت ریسک هوش مصنوعی مؤسسهٔ ملی استاندارد و فناوری آمریکا (NIST AI RMF 1.0، بهمن ۱۴۰۱) هم از زمینهٔ همان سامانه و کاربرد شروع میکند. کارکرد Map، یکی از چهار کارکرد اصلی آن (Govern، Map، Measure و Manage)، به تعبیر NIST زمینهای را روشن میکند که ریسکهای یک سامانهٔ هوش مصنوعی در آن قاببندی میشوند. این چارچوب داوطلبانه و اینجا «مرجع» است، نه «الزام برای شما»؛ NIST اعلام کرده نسخهٔ ۱٫۰ در حال بازنگری است.
کدام کار را برای سنجش انتخاب کنیم؟
کار نامزد خوب سه شرط دارد: خروجیاش پیشنویسی است که انسان بررسی میکند، تکرار میشود، و خطایش برگشتپذیر است. انتخاب کار نیمی از ارزیابی است؛ کار نامناسب با هر نمرهای آزمایش بدی میسازد.
- پیشنویس، نه اقدام. اگر خروجی پیش از رسیدن به مشتری، سامانه یا تصمیم از زیر دست یک نفر رد شود، خطا جایی گرفته میشود که هنوز ارزان است.
- تکرار. کاری که هر روز یا هر هفته انجام میشود، در چند هفته نمونهٔ کافی برای مقایسه میدهد. گزارشی که سالی یک بار نوشته میشود، این امکان را ندارد.
- خطای برگشتپذیر. پیشنویس اشتباه را میشود اصلاح کرد؛ پیامکی که به هزار مشتری رفته را نه.
Anthropic در یادداشت «Building effective agents» (آذر ۱۴۰۳) میان گردشکار، با مسیری که از پیش در کد تعیین شده، و عامل، که ترتیب گامها و ابزارهایش در حین اجرا تعیین میشود، فرق میگذارد و توصیه میکند سادهترین راهحل ممکن را پیدا کنید و پیچیدگی را فقط وقتی لازم شد بیفزایید. ابزارهای آن یادداشت از آن زمان تغییر کردهاند، اما اصل کلی به کار میآید؛ کار اول را طوری انتخاب کنید که سادهترین شکلش هم ارزش داشته باشد.
نامزدهای خوب برای شروع:
- پیشنویس گزارش هفتگی وضعیت یک پروژه، از روی گزارشهای واحدها
- خلاصهٔ صورتجلسه و فهرست مصوبات، برای بازبینی دبیر جلسه
- پیدا کردن سابقهٔ یک تصمیم یا مکاتبه در پروندههای گذشته
- پیشنویس پاسخ به پرسشهای تکراری مشتری، برای تأیید کارشناس
نامزدهای بد برای شروع:
- تغییر خودکار وضعیت سفارش، موجودی یا قیمت در سامانهٔ عملیاتی
- هر پیامی که بدون بازبینی به مشتری یا نهاد بیرونی میرود
- تصمیم دربارهٔ افراد، مثل ارزیابی عملکرد یا گزینش
- کاری که منبعش فقط در ذهن یک نفر است
پیش از جلسه، کار نامزد را در یک جمله بنویسید؛ مثلاً «پیشنویس گزارش هفتگی آمادگی مرکز توزیع برای جلسهٔ مدیران». اگر نوشتن همین جمله بیش از چند دقیقه بحث داشت، کار هنوز برای سنجش مشخص نیست.
خودارزیابی چه پرسشهایی دارد و چطور نمره بدهیم؟
خودارزیابی بیست پرسش در پنج محور دارد و هر پرسش ۰، ۱ یا ۲ نمره میگیرد؛ جمع از ۴۰ است. لنگر نمرهها ثابت است تا دو گروه مختلف به یک وضعیت یک نمره بدهند:
- ۰: نه، یا نمیدانیم.
- ۱: تا حدی، یا فقط شفاهی؛ «همه میدانند»، اما جایی نوشته نشده است.
- ۲: بله، و مکتوب؛ سند، فهرست یا نمونهاش را همین حالا میتوانید نشان دهید.
دستور اجرا: صاحب کار، یک کاربر نهایی که خروجی را مصرف میکند و یک نفر از فناوری اطلاعات یا امنیت، با هم و در یک جلسهٔ حدود ۴۵ دقیقهای. هر پرسشی که بر سرش اختلاف بود، نمرهٔ پایینتر را میگیرد. برای هر نمرهٔ ۲ در ستون «شاهد» بنویسید آن سند کجاست؛ نمرهٔ ۲ بدون شاهد، ۱ حساب میشود.
فایل خودارزیابی
فایل CSV خودارزیابی آمادگی در دامنهٔ یک کار همین بیست پرسش را با ستونهای نمره، شاهد و خط قرمز، و جای نام کار و شرکتکنندگان دارد. در اکسل یا هر صفحهگستردهای باز میشود.
کار و نتیجه
اگر خروجی و معیار «کافی» روشن نباشد، هیچ آزمایشی نمیتواند بگوید موفق شده یا نه.
- ۱. خروجی کار دقیقاً چیست و یک نمونهٔ خوبِ آن را داریم؟
- ۲. معیار «کافی بودن» خروجی مکتوب است؟
- ۳. کار آنقدر تکرار میشود که آزمایش معنا داشته باشد؟
- ۴. برآوردی داریم که امروز این کار چقدر وقت میگیرد و چه خطاهایی دارد؟
پرسش ۴ را دستکم نگیرید. بدون برآورد وضعیت امروز، پایان آزمایش فقط یک «به نظرم بهتر شد» میماند.
منبع و داده
خروجی هر عامل در بهترین حالت به اندازهٔ منابعش درست است، و در بسیاری از سازمانهای ما بخشی از منابع در نامههای اسکنشده، فایلهای اکسل روی رایانهٔ شخصی و پیامهای صوتی پیامرسانهاست.
- ۵. منابع معتبر این کار فهرست شدهاند و معلوم است از کدام منبع نباید استفاده شود؟
- ۶. هر منبع مالک و زمان بهروزرسانی مشخص دارد؟
- ۷. منابع به شکل خواندنی در دسترساند، نه فقط تصویر اسکن یا پیام صوتی پراکنده؟
- ۸. حساسیت دادههای این کار طبقهبندی شده و معلوم است کدام داده نباید از سازمان خارج شود؟ (خط قرمز)
OWASP در فهرست ده ریسک برنامههای مبتنی بر مدل زبانی (نسخهٔ ۲۰۲۵)، «افشای اطلاعات حساس» را با شناسهٔ LLM02 آورده است. پرسش ۸ همین را پیش از هر آزمایشی میپرسد. نمرهٔ ۲ یعنی طبقهبندی برای همین کار نوشته شده، نه اینکه سازمان «یک سیاست کلی امنیت اطلاعات» دارد.
معنا و تعریف
دو واحد میتوانند یک واژه را به دو معنا به کار ببرند و هر دو درست بگویند؛ خروجیای که روی این ابهام ساخته شود، مرتب به نظر میرسد و غلط است.
- ۹. واژههای کلیدی کار (مثل «آماده» یا «تحویلشده») تعریف مشترک مکتوب دارند؟
- ۱۰. اگر دو واحد روایت متفاوت دارند، معلوم است مرجع کدام است؟
- ۱۱. استثناهای پرتکرار کار نوشته شدهاند؟
- ۱۲. نمونههای واقعی گذشته با خروجی درست، برای مقایسه داریم؟
اختیار و تأیید
خودکارسازی همهیاهیچ نیست. پاراسورامان، شریدان و ویکنز در الگوی مشهور سال ۲۰۰۰ خود پیشنهاد کردند که خودکارسازی میتواند به گردآوری اطلاعات، تحلیل آن، انتخاب تصمیم یا اجرای اقدام بپردازد و در هر کدام سطح متفاوتی داشته باشد. پرسش ۱۴ همین را ساده میپرسد: عامل فقط پیشنهاد میدهد، پیشنویس کامل برای بازبینی میسازد، یا اقدام میکند و چیزی را در سامانه تغییر میدهد یا بیرون میفرستد؟
- ۱۳. یک مسئول انسانی با نقش مشخص، خروجی را پیش از استفاده تأیید میکند؟ (خط قرمز)
- ۱۴. مرز اختیار روشن است؛ پیشنهاد، پیشنویس یا اقدام؟
- ۱۵. شرط توقف و ارجاع به انسان نوشته شده است؟ (خط قرمز)
- ۱۶. معلوم است اگر خروجی اشتباه به تصمیم برسد، پاسخگو کیست؟
ارزیابی و ریسک
بدون نمونههای آزمون و معیار پایان، آزمایش هیچوقت تمام نمیشود؛ فقط کمکم فراموش میشود.
- ۱۷. مجموعهای از ۲۰ تا ۳۰ نمونهٔ آزمون با پاسخ درست داریم یا میتوانیم بسازیم؟
- ۱۸. هزینهٔ یک خطا را میدانیم و خطا برگشتپذیر است؟
- ۱۹. کاربران نهایی در طراحی آزمایش مشارکت دارند؟
- ۲۰. معیار پایان آزمایش (ادامه یا توقف) از پیش تعیین شده است؟
عدد ۲۰ تا ۳۰ قاعدهٔ تجربی ماست: آنقدر زیاد که چند استثنای رایج را دربر بگیرد و آنقدر کم که یک نفر در یکی دو روز پاسخ درستشان را بنویسد. برای فهرست کاملتر ریسکهای ویژهٔ هوش مصنوعی مولد، نیمرخ هوش مصنوعی مولد NIST (NIST AI 600-1، مرداد ۱۴۰۳) مکمل همان چارچوب AI RMF است.
نمره را چطور به تصمیم تبدیل کنیم؟
اول سه پرسش خط قرمز را نگاه کنید و بعد جمع را؛ اگر پرسش ۸، ۱۳ یا ۱۵ صفر باشد، تصمیم «فعلاً نه» است، هر جمعی که داشته باشید.
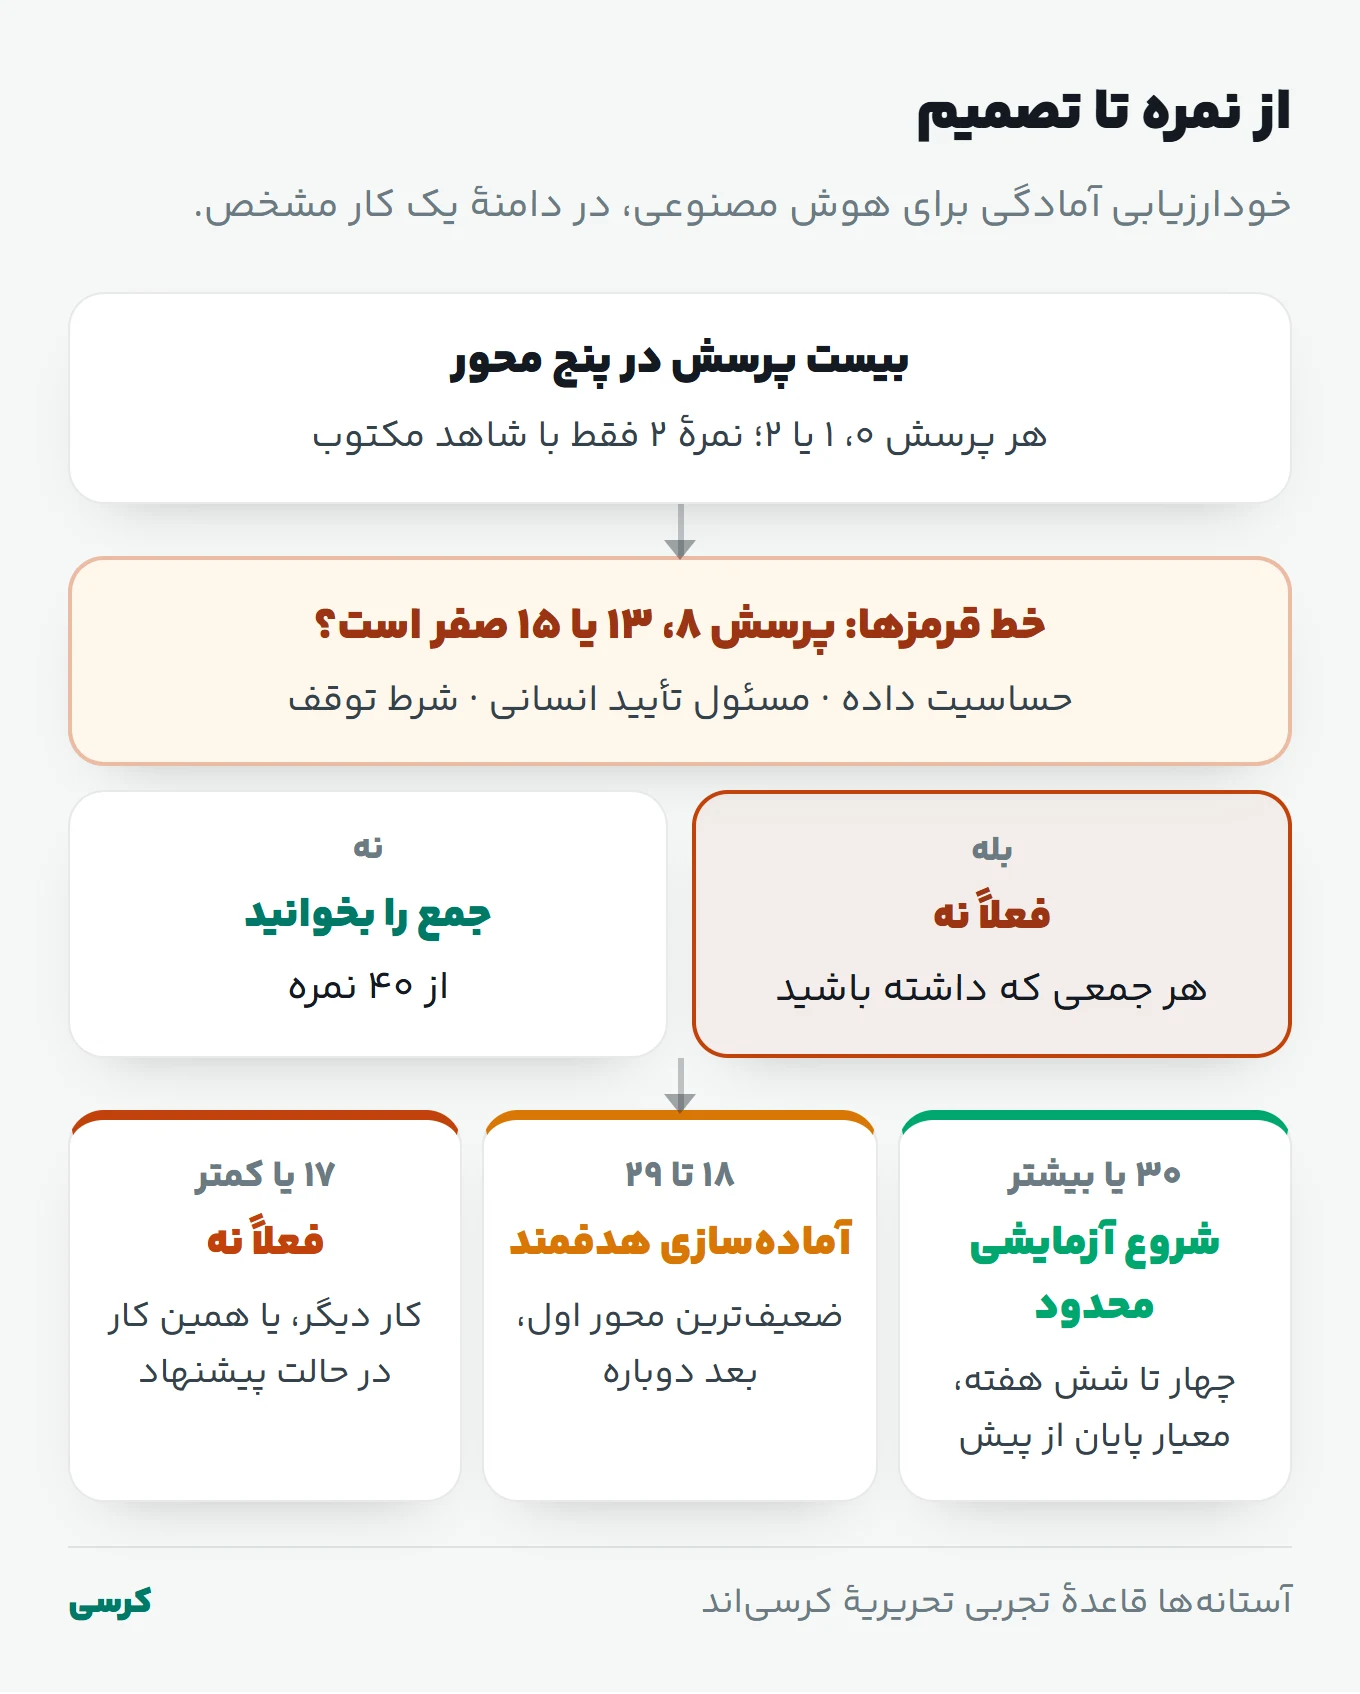
- پرسش ۸، حساسیت داده. اگر ندانید کدام داده نباید بیرون برود، خود آزمایش ممکن است همان داده را جابهجا کند.
- پرسش ۱۳، مسئول تأیید. بدون نقشی مشخص که خروجی را پیش از استفاده ببیند، «پیشنویس» در عمل «اقدام» است.
- پرسش ۱۵، شرط توقف و ارجاع. اگر ننوشتهاید عامل در چه وضعیتی باید کار را متوقف و به انسان ارجاع دهد، موارد مبهم هم مثل موارد عادی خروجی میگیرند.
اگر هیچ خط قرمزی صفر نبود، جمع را با این جدول بخوانید:
| جمع (از ۴۰) | تصمیم | گام بعد |
|---|---|---|
| ۳۰ یا بیشتر | شروع آزمایشی محدود | چهار تا شش هفته، دامنهٔ کوچک، معیار پایان از پیش |
| ۱۸ تا ۲۹ | آمادهسازی هدفمند | ضعیفترین محور را اول درست کنید، بعد دوباره بسنجید |
| ۱۷ یا کمتر | فعلاً نه | کار دیگری انتخاب کنید، یا همین کار را در حالت فقط پیشنهاد دوباره بسنجید |
منطق آستانهها ساده است. جمع ۳۰ یعنی میانگین ۱٫۵ در هر پرسش؛ دستکم نیمی از پاسخها مکتوباند. جمع ۱۷ یا کمتر یعنی بیش از نیمی از پرسشها صفر یا فقط شفاهیاند و آمادهسازی چنین کاری احتمالاً بیش از یکی دو کار یکهفتهای لازم دارد.
سه حالت مرزی هم قاعدهٔ روشن دارند:
- خط قرمز با نمرهٔ ۱ مانع شروع نیست، اما باید در هفتهٔ اول آزمایش مکتوب شود و به ۲ برسد.
- «فعلاً نه» فقط بهخاطر یک خط قرمز، وقتی جمع ۱۸ یا بیشتر است، معمولاً ارزانترین مسیر را دارد؛ همان یک مورد را بنویسید و دوباره بسنجید.
- جمع بالا با یک محور ضعیف همچنان شروع آزمایشی است، اما درستکردن آن محور کار هفتهٔ اول آزمایش میشود.
دربارهٔ آستانهها
این آستانهها قاعدهٔ تجربی تحریریهٔ کرسیاند، نه مقیاسی که بهطور علمی اعتبارسنجی شده باشد. کارشان این است که گفتوگو را به تصمیم برسانند. اگر سازمان شما دلیل روشنی برای آستانهٔ سختگیرانهتر دارد، آن را پیش از جلسه بنویسید و همان را به کار ببرید.
قاعده کجا «آری» و کجا «نه» میگوید؟ دو نمونهٔ کارشده (فرضی)
هر دو نمونه در همان شرکت پخش فرضی میگذرند؛ یک سازمان، دو کار، دو جواب. نمونههای فرضیاند؛ نمرهها برای نشان دادن روشاند. در جدولها، نمرهٔ چهار پرسش هر محور به ترتیب شماره آمده است.
پیشنویس گزارش هفتگی آمادگی مرکز توزیع؛ نمرهٔ ۳۱، شروع آزمایشی
شرکتکنندگان: مدیر پروژهٔ مرکز توزیع (صاحب کار)، یکی از مدیرانی که گزارش را میخواند و یک کارشناس فناوری اطلاعات.
| محور | نمرهٔ پرسشها | جمع محور |
|---|---|---|
| کار و نتیجه (۱ تا ۴) | ۲ · ۱ · ۲ · ۱ | ۶ از ۸ |
| منبع و داده (۵ تا ۸) | ۲ · ۱ · ۲ · ۲ | ۷ از ۸ |
| معنا و تعریف (۹ تا ۱۲) | ۱ · ۱ · ۱ · ۲ | ۵ از ۸ |
| اختیار و تأیید (۱۳ تا ۱۶) | ۲ · ۲ · ۲ · ۱ | ۷ از ۸ |
| ارزیابی و ریسک (۱۷ تا ۲۰) | ۱ · ۲ · ۱ · ۲ | ۶ از ۸ |
| جمع | خط قرمزهای ۸، ۱۳ و ۱۵ همه ۲ | ۳۱، شروع آزمایشی محدود |
نمرههای ۱ هر کدام یک دلیل مشخص دارند. معیار «کافی» (پرسش ۲) شفاهی است؛ مدیران میگویند «گزارش خوب را میشناسیم»، اما ننوشتهاند. گزارش واحد نیروی انسانی مالک ثابت ندارد (پرسش ۶). گزارشهای بیست هفتهٔ گذشته موجودند (پرسش ۱۲)، اما پاسخ درست برای آزمون هنوز از آنها استخراج نشده است (پرسش ۱۷).
ضعیفترین محور «معنا» است. «آماده» برای تجهیزات تعریف مکتوب ندارد؛ واحد فنی «نصبشده» را آماده میداند و واحد عملیات «آزمایششده» را. پس اولین کار هفتهٔ اول آزمایش، نوشتن تعریف «آماده» برای تجهیزات، نیروی انسانی و سامانههاست.
مرز اختیار روشن است. عامل فقط پیشنویس میدهد. ارسال گزارش و تغییر وضعیت پرونده تأیید مدیر پروژهٔ مرکز توزیع را لازم دارد. معیار کیفیت: هر ادعای وضعیت منبع و تاریخ دارد و مدیر پروژه پیشنویس را بدون اصلاح اساسی تأیید میکند؛ همان نمونهای که در برگهٔ تعریف کار انسان و عامل پر شده است.
یک نکتهٔ عملی: کار هفتگی در شش هفته فقط شش خروجی زنده میدهد. برای همین مجموعهٔ آزمون از گزارشهای گذشته ساخته میشود؛ منابع هر هفته به عامل داده میشود و پیشنویسش با گزارشی که آن هفته واقعاً تأیید شد مقایسه میشود.
بهروزرسانی خودکار وضعیت سفارشها در سامانهٔ فروش؛ نمرهٔ ۱۷ و یک خط قرمز، فعلاً نه
کار این است: عامل پیامهای مشتری را میخواند و وضعیت سفارش را در سامانهٔ فروش تغییر میدهد؛ سامانه هم تغییر را با پیامک به مشتری اطلاع میدهد.
| محور | نمرهٔ پرسشها | جمع محور |
|---|---|---|
| کار و نتیجه (۱ تا ۴) | ۲ · ۱ · ۲ · ۱ | ۶ از ۸ |
| منبع و داده (۵ تا ۸) | ۱ · ۱ · ۱ · ۱ | ۴ از ۸ |
| معنا و تعریف (۹ تا ۱۲) | ۰ · ۰ · ۱ · ۱ | ۲ از ۸ |
| اختیار و تأیید (۱۳ تا ۱۶) | ۱ · ۱ · ۰ · ۰ | ۲ از ۸ |
| ارزیابی و ریسک (۱۷ تا ۲۰) | ۱ · ۰ · ۱ · ۱ | ۳ از ۸ |
| جمع | خط قرمز ۱۵ برابر ۰ | ۱۷، فعلاً نه |
دلیل نمرههای پایین روشن است. بخشی از پیامهای مشتری صوتیاند و در پیامرسان میمانند (پرسش ۷). «تحویلشده» در انبار یعنی «از انبار خارج شد» و در فروش یعنی «مشتری تحویل گرفت»، و معلوم نیست مرجع کدام است (پرسشهای ۹ و ۱۰). شرط توقف نوشته نشده (پرسش ۱۵) و پاسخگوی خطا معلوم نیست (پرسش ۱۶). تغییر وضعیت فوراً به مشتری اطلاع داده میشود، پس خطا بهراحتی برنمیگردد (پرسش ۱۸).
تصمیم از دو راه «فعلاً نه» است: یک خط قرمز صفر است و جمع هم ۱۷ است. اما «فعلاً نه» برای این شکل کار است، نه برای این مسئله.
بازطراحی در حالت پیشنهاد. همان کار را اینطور تعریف کنید: عامل وضعیت پیشنهادی را با پیام مشتری به کارشناس فروش نشان میدهد و کارشناس آن را تأیید یا رد میکند؛ ثبت وضعیت و اطلاع به مشتری با کارشناس است. چهار پرسش تغییر میکنند:
| پرسش | پیش از | پس از | دلیل |
|---|---|---|---|
| ۱۳، مسئول تأیید | ۱ | ۲ | کارشناس فروش هر پیشنهاد را پیش از ثبت تأیید میکند و این نقش در شرح کار نوشته میشود |
| ۱۴، مرز اختیار | ۱ | ۲ | عامل فقط پیشنهاد میدهد؛ ثبت و اطلاع به مشتری با کارشناس است |
| ۱۵، شرط توقف | ۰ | ۲ | نوشته میشود که پیام صوتی، پیام مبهم یا وضعیت ناهمخوان با انبار بدون پیشنهاد به کارشناس ارجاع شود |
| ۱۸، هزینهٔ خطا | ۰ | ۱ | خطا پیش از رسیدن به مشتری دیده میشود، اما هزینهٔ تأیید اشتباه هنوز برآورد نشده است |
جمع تازه ۲۲ از ۴۰ است (محورها به ترتیب ۶، ۴، ۲، ۶ و ۴) و هیچ خط قرمزی صفر نیست؛ تصمیم «آمادهسازی هدفمند» است. ضعیفترین محور هنوز «معنا» است. اگر انبار و فروش بر یک تعریف از «تحویلشده» و یک مرجع توافق کنند (پرسشهای ۹ و ۱۰ به ۲) و پاسخگوی خطا دستکم شفاهی روشن شود (پرسش ۱۶ به ۱)، جمع به ۲۷ میرسد. هنوز زیر ۳۰ است؛ قدم بعد ساختن نمونههای آزمون و برآورد هزینهٔ خطاست. آمادهسازی واقعی همین است: چند گام کوچک که هر کدام در نمره دیده میشود.
بعد از نمره چه کنیم؟
هر سه تصمیم گام بعد مشخص دارند و هیچکدام «خرید ابزار» نیست.
اگر «شروع آزمایشی» آمد
پیش از روز اول، این شش چیز را روی یک صفحه بنویسید:
- دامنه: یک کار، یک واحد و یک گروه کوچک کاربر.
- مدت: چهار تا شش هفته، با تاریخ پایان.
- مسئول: تأییدکنندهٔ خروجی و پاسخگوی آزمایش؛ ممکن است یک نفر باشند.
- نمونههای آزمون: ۲۰ تا ۳۰ نمونه با پاسخ درست، پیش از شروع.
- معیار ادامه یا توقف: مثلاً سهم پیشنویسهایی که بدون اصلاح اساسی تأیید شدند، یا خطایی که اگر یک بار رخ دهد آزمایش متوقف میشود.
- ضعیفترین محور: کاری که در هفتهٔ اول برای بالا بردنش انجام میشود.
برای نوشتن هدف، منابع، مالک انسانی، اختیار و ارجاع، از برگهٔ تعریف کار انسان و عامل استفاده کنید؛ چهار خانهٔ اصلی آن در مقالهٔ پیش از ورود عاملها توضیح داده شده است.
اگر «آمادهسازی» آمد
برای ضعیفترین محور، یکی از این کارهای یکهفتهای را انتخاب کنید و بعد با همان سه نفر دوباره بسنجید:
- کار و نتیجه: دو نمونهٔ خوب و یک نمونهٔ بد از خروجی را کنار هم بگذارید و معیار «کافی» را در سه تا پنج جمله بنویسید.
- منبع و داده: فهرست منابع معتبر کار را با مالک و زمان بهروزرسانی هر کدام بنویسید، و یک خط برای منابعی که نباید استفاده شوند. برای منبعی که فقط در ذهن افراد است، حافظه سازمانی چیست؟ را ببینید.
- معنا و تعریف: سه واژهٔ کلیدی کار را تعریف کنید و برای اختلاف دو واحد مرجع تعیین کنید. ویکی سازمانی جای ماندگار همین تعریفهاست.
- اختیار و تأیید: مسئول تأیید را با نقش (نه فقط با نام) تعیین کنید و در یک بند بنویسید عامل در چه وضعیتهایی کار را متوقف و به انسان ارجاع دهد.
- ارزیابی و ریسک: ۲۰ تا ۳۰ نمونه از کارهای گذشته را با پاسخ درست جمع کنید و معیار ادامه یا توقف آزمایش را پیش از شروع بنویسید.
اگر «فعلاً نه» آمد
«فعلاً نه» شکست نیست؛ صرفهجویی است، چون هزینه و اعتمادی را که یک آزمایش شکستخورده از بین میبرد نگه میدارد. یکی از نامزدهای خوب را جایگزین کنید، یا همین کار را مثل نمونهٔ دوم در حالت فقط پیشنهاد دوباره بسنجید.
این خودارزیابی چه چیزی را نمیسنجد؟
این خودارزیابی فقط میگوید یک کار مشخص برای یک آزمایش محدود آماده است یا نه؛ بقیهٔ پرسشهای مهم را باید جای دیگری پاسخ داد.
- ممیزی امنیت نیست. پرسش ۸ میپرسد طبقهبندی وجود دارد یا نه؛ اینکه کنترلهای امنیتی کافیاند، کار تیم امنیت است.
- ارزیابی انطباق حقوقی یا حفاظت از داده نیست. پیش از کار با دادههای شخصی یا محرمانه، با مسئول حقوقی و امنیت سازمان بررسی کنید.
- انتخاب مدل یا فروشنده نیست. پرسشها عمداً به هیچ ابزاری اشاره نمیکنند.
- محاسبهٔ بازگشت سرمایه نیست. پرسش ۴ فقط پایهای برای مقایسه میسازد، نه برآورد مالی.
- جایگزین چارچوب کامل مدیریت ریسک نیست. NIST AI RMF مرجع کاملتری است، و اگر سازمان به نظام مدیریت هوش مصنوعی در سطح کل سازمان فکر میکند، استانداردهایی مثل ISO/IEC 42001:2023 برای همان سطح نوشته شدهاند.
- برای هر کار باید جدا تکرار شود. نمرهٔ یک کار به کار دیگر منتقل نمیشود، حتی در همان واحد.
کجا زیادی است؟ اگر یک نفر برای پیشنویس یک ایمیل شخصی، بدون دادهٔ حساس، از یک دستیار عمومی کمک میگیرد، جلسهٔ سهنفره لازم نیست؛ یک قاعدهٔ کوتاه دربارهٔ اینکه چه دادهای نباید در این ابزارها وارد شود کافی است. هزینهٔ روش هم صفر نیست: سه نفر، ۴۵ دقیقه و زمان جمعکردن شاهدها؛ هزینهای که برای کاری میارزد که قرار است هفتهها تکرار شود.
وقتی چند کار سنجیده و آماده شد، تعریفها و منابعی که برایشان نوشتهاید پایهٔ قدمهای بعدی میشوند؛ مسیری که در از ویکی تا مدل زنده سازمان دنبالش کردهایم.
این هفته از کجا شروع کنیم؟
یک کار، سه نفر و یک جلسهٔ ۴۵ دقیقهای کافی است تا پاسخ هیئتمدیره از «در حال بررسی هستیم» به یک تصمیم مشخص برسد.
- یک کار نامزد را در یک جمله بنویسید و سه شرط کار خوب را برایش بررسی کنید.
- صاحب کار، یک کاربر نهایی و یک نفر از فناوری اطلاعات یا امنیت را برای یک جلسهٔ ۴۵ دقیقهای دعوت کنید.
- فایل CSV را باز کنید و پیش از جلسه، شاهدهای موجود را کنار پرسشها بنویسید.
- در جلسه به بیست پرسش نمره بدهید؛ اختلاف یعنی نمرهٔ پایینتر، و ۲ بدون شاهد یعنی ۱.
- اول خط قرمزها (۸، ۱۳ و ۱۵) و بعد جمع را با جدول تصمیم بخوانید.
- تصمیم، ضعیفترین محور و گام بعد را در یک بند بنویسید و تاریخ سنجش دوباره را تعیین کنید.
یک بند برای هیئتمدیره (با نمونهٔ فرضی اول)
«برای پیشنویس گزارش هفتگی آمادگی مرکز توزیع، خودارزیابی آمادگی نمرهٔ ۳۱ از ۴۰ داد و هر سه خط قرمز مکتوباند. یک آزمایش ششهفتهای با مسئولیت مدیر پروژهٔ مرکز توزیع شروع میکنیم؛ عامل فقط پیشنویس میدهد و ارسال گزارش با تأیید اوست. ضعیفترین محور، تعریف «آماده» است که در هفتهٔ اول نوشته میشود. معیار ادامه یا توقف از پیش نوشته شده و نتیجه را پس از شش هفته گزارش میکنیم.»
در کرسی
شناخت مستند سازمان و جریان کار، پایهٔ همکاری با کرسی است (عرضهشده). دستیار هوش مصنوعی خود سازمان، مثل Claude یا ChatGPT، میتواند به کرسی وصل شود؛ با همان دسترسیهای هر کاربر میخواند و تغییرها را برای تأیید او آماده میکند. این اتصال برای هر نسخهٔ کرسی جداگانه فعال میشود (مشروط یا سفارشی). مدل بهروز یک دامنهٔ سازمان، چشمانداز توسعه است و باید در دامنهٔ واقعی اعتبارسنجی شود (چشمانداز). وضعیت هر کدام در سازمان آماده AI آمده است.
اگر خواستید دربارهٔ اولین کار با ما گفتوگو کنید، از صفحهٔ گفتوگو شروع کنید؛ یک کار مشخص را انتخاب کنیم، و هدف، منابع و حدود اختیار را روشن کنیم.
پرسشهای متداول
آمادگی سازمان برای هوش مصنوعی را از کجا شروع کنیم؟
از یک کار تکراری که خروجیاش پیشنویس یا پیشنهاد است و یک انسان پیش از استفاده بررسیاش میکند، مثل پیشنویس گزارش هفتگی یک پروژه. آمادگی را در دامنهٔ همان کار با بیست پرسش بسنجید، نه برای کل سازمان. نتیجه یکی از سه تصمیم است؛ شروع آزمایشی محدود، آمادهسازی هدفمند یا فعلاً نه.
آیا پیش از استفاده از هوش مصنوعی باید همهٔ دادهها و اسناد سازمان مرتب شوند؟
نه. فقط منابع همان کاری که میسنجید باید معتبر، دارای مالک و زمان بهروزرسانی، و خواندنی باشند؛ یعنی متنی که بشود در آن جستوجو کرد، نه فقط تصویر اسکن یا پیام صوتی. از یک کار کوچک شروع کنید و دامنه را با تجربه گسترش دهید. مرتبکردن همهٔ اسناد پیش از هر آزمایشی، شروع را عقب میاندازد بیآنکه معلوم باشد کدام سند به کار میآید.
خودارزیابی آمادگی هوش مصنوعی را چه کسی پر کند؟
سه نفر با هم، در جلسهای حدود ۴۵ دقیقهای؛ صاحب کار، یک کاربر نهایی که خروجی را مصرف میکند و یک نفر از فناوری اطلاعات یا امنیت. هر پرسشی که بر سرش اختلاف بود، نمرهٔ پایینتر را میگیرد. نمرهٔ ۲ فقط وقتی داده میشود که سند یا نمونهاش را بتوان همانجا نشان داد.
نمرهٔ بالا در ارزیابی آمادگی یعنی ابزار بخریم؟
نه. نمرهٔ بالا یعنی یک آزمایش محدود، با دامنهٔ کوچک، مسئول مشخص و معیار پایانی که از پیش نوشته شده، ارزش انجام دارد. انتخاب ابزار یا فروشنده تصمیم جداگانهای است و بهتر است بعد از دیدن نتیجهٔ همان آزمایش گرفته شود، نه پیش از آن.
ایجنت هوش مصنوعی برای کار ما آماده است یا نه؟
پاسخ به کار بستگی دارد، نه به سازمان. همین بیست پرسش را برای همان کار مشخص پاسخ دهید. پرسش ۱۴ (مرز اختیار) روشن میکند که عامل هوش مصنوعی فقط پیشنهاد بدهد، پیشنویس تهیه کند یا اقدام کند. بیشتر کارها برای شروع، در حالت پیشنهاد یا پیشنویس نمرهٔ بهتری میگیرند تا در حالت اقدام.
منابع و مطالعهٔ بیشتر
- NIST, Artificial Intelligence Risk Management Framework (AI RMF 1.0), NIST AI 100-1, January 2023صفحهٔ رسمی چارچوب مدیریت ریسک هوش مصنوعی NIST؛ همین صفحه میگوید نسخهٔ ۱.۰ در حال بازنگری است
- NIST AI Resource Center, AI RMF Core (Section 5)چهار کارکرد Govern، Map، Measure و Manage، و تعریف کارکرد Map بهعنوان تعیین زمینهٔ ریسک یک سامانه
- NIST AI 600-1, Artificial Intelligence Risk Management Framework, Generative Artificial Intelligence Profile, July 2024نیمرخ هوش مصنوعی مولد، مکمل AI RMF برای استفادهٔ داوطلبانه
- Anthropic, Building effective agents, December 2024تمایز گردشکار و عامل، و توصیه به سادهترین راهحل ممکن
- Parasuraman, R., Sheridan, T. B. & Wickens, C. D. (2000). A model for types and levels of human interaction with automation. IEEE Transactions on Systems, Man, and Cybernetics, Part A, 30(3), 286–297الگوی کلاسیک نوع و سطح خودکارسازی؛ پشتوانهٔ محور اختیار و تأیید
- OWASP Top 10 for LLM Applications 2025, LLM02:2025 Sensitive Information Disclosureریسک افشای اطلاعات حساس در برنامههای مبتنی بر مدل زبانی؛ پشتوانهٔ پرسش ۸
- ISO/IEC 42001:2023, Information technology, Artificial intelligence, Management systemاستاندارد نظام مدیریت هوش مصنوعی در سطح سازمان؛ فقط برای مرزگذاری با این خودارزیابی
تحریریهٔ کرسی از تجربهٔ کار با سازمانها در شناخت، ثبت تصمیم و پیگیری اقدام مینویسد. هر مقاله پیش از انتشار با تیم محصول و همکاری مرور میشود تا آنچه دربارهٔ کرسی میگوید با محصول واقعی یکی باشد.